Как устроен ChatGPT? Полное погружение в принципы работы и спектр возможностей самой известной нейросети в мире стр. 6

language model, LLM) – лежит в основе ChatGPT, и она была специально создана для того, чтобы выполнять оценку этих вероятностей.
Что такое модель?Предположим, что вы (подобно Галилею в конце 1500-х годов) хотите знать, сколько времени будет падать пушечное ядро, если сбросить его поочередно со всех этажей Пизанской башни. Вы можете просто замерить время в каждом конкретном случае и составить таблицу результатов. Или сделать то, что является сутью теоретической науки: создать модель, которая позволит вам вычислить ответ, вместо того чтобы проводить серию экспериментов и получать данные эмпирическим путем.
Давайте представим, что у нас есть (несколько усредненные) данные о том, сколько времени требуется пушечному ядру, чтобы долететь до земли при падении с разных этажей:
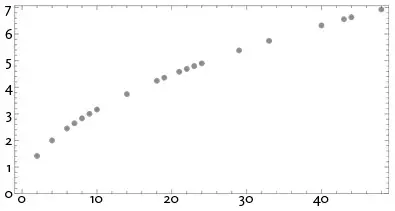
Как мы можем выяснить, сколько времени потребуется ядру, чтобы долететь до земли при падении с конкретного этажа, если не проводили эксперимент? В этом случае мы можем использовать известные законы физики. Но, допустим, все, что у нас есть, – это экспериментальные данные, и мы не знаем, какие основополагающие физические законы управляют движением ядра. Тогда мы могли бы сделать математическое предположение, например, что, возможно, нам следует использовать в качестве модели прямую линию:
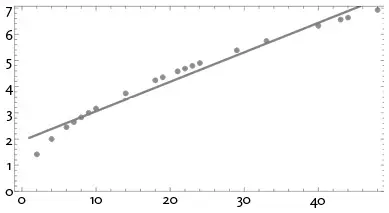
Можно было бы провести разные прямые линии. Но эта линия в среднем ближе всего к полученным нами данным. И по этой прямой мы можем оценить время падения ядра с любого этажа.
Как мы поняли, что нужно провести прямую линию? Это следует из самых основ математики. Мы привыкли к тому, что множество эмпирически полученных данных хорошо описываются с помощью простых математических формул. Мы могли бы попробовать что-нибудь математически более сложное, скажем: a + bx + cx 2 , и тогда у нас получится следующее:
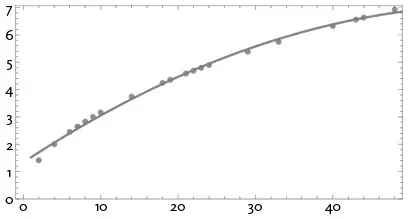
Однако результат может быть и не таким, как нам надо. Вот, например, что выйдет, если мы используем формулу a + b: x + c × sin(x):
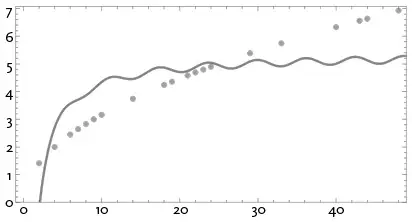
Нужно понимать, что не существует модели без модели. То есть любая модель, которую вы используете, имеет определенную базовую структуру и набор параметров, которые вы можете установить и которые соответствуют вашим данным. И в случае с ChatGPT тоже используется множество параметров (на самом деле их 175 миллиардов).
Примечательно, что лежащая в основе ChatGPT структура (с таким «небольшим» количеством параметров) способна создавать модель, которая вычисляет вероятности следующего слова достаточно хорошо, чтобы у нас получились фрагменты текста размером с настоящее эссе.
Модели для человеческих задачПример, который мы привели выше, предполагает создание модели числовых данных, которая, по сути, основана на простой физике и старой доброй прикладной математике. Но для ChatGPT мы должны создать модель текста, который будет подобен тому, что написал бы человек. И для этого у нас нет (по крайней мере, пока) ничего похожего на базовую прикладную математику. Итак, что же это за модель?
Прежде чем мы поговорим о языке, давайте обсудим другую сугубо человеческую задачу – распознавание образов. И в качестве простого примера предлагаю рассмотреть изображения цифр (это классический пример машинного обучения):
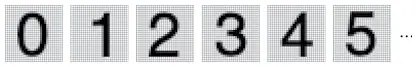
Мы можем взять ряд изображений каждой цифры:
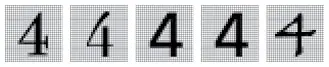
Затем, чтобы выяснить, соответствует ли изображение, полученное нами в качестве входных данных, определенной цифре, мы могли бы сравнить его с имеющимися у нас образцами пиксель за пикселем. Но мы, люди, выполняем эту задачу намного лучше, потому что способны распознать цифры, даже если они написаны от руки и имеют всевозможные модификации и искажения:
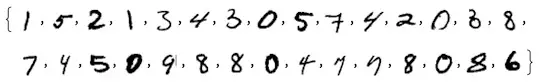
Создавая описанную выше модель для наших числовых данных, мы взяли определенное числовое значение x и просто вычислили a + bx для конкретных a и b. В данном случае, если мы определим цвет каждого пикселя как некую переменную xi, есть ли какая-то функция всех этих переменных, которая – при вычислении – скажет нам, какая цифра изображена в этом случае? Оказывается, такую функцию можно построить. Однако это не так-то просто. И типичный пример