Как устроен ChatGPT? Полное погружение в принципы работы и спектр возможностей самой известной нейросети в мире стр. 8

место, а все двойки – в другое. Иными словами, если изображение больше похоже на единицу, чем на двойку, мы хотим, чтобы оно оказалось единицей, и наоборот. Эти «зоны притяжения» и называются аттракторами (от англ. attract – привлекать, притягивать).
В качестве простой аналогии предположим, что есть определенные позиции на плоскости, отмеченные точками (в реальной жизни это могут быть кафе, обозначенные на карте). Предположим, что, двигаясь из любого места, мы хотим оказаться в ближайшей к нам точке, то есть в ближайшем кафе. Мы можем представить эту плоскость разделенной на области – зоны аттракторов, разграниченные чем-то вроде водоразделов:
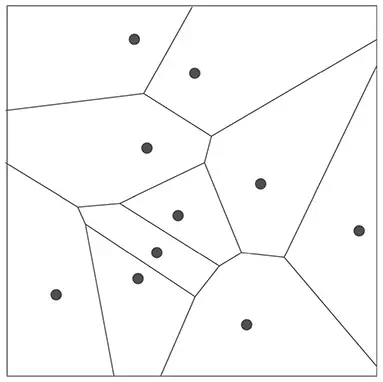
Это можно рассматривать как своего рода задачу на распознавание, где мы не пытаемся понять, на какую цифру похоже изображение, а стараемся увидеть, к какой точке определенная точка находится ближе всего.
(Диаграмма Вороного, которую мы здесь построили, разделяет точки в двумерном евклидовом пространстве; задачу распознавания цифр можно рассматривать как нечто очень похожее, но в 784-мерном пространстве, сформированном из уровней серого всех пикселей на каждом изображении.)
Итак, как мы можем заставить нейронную сеть «распознать» что-то? Давайте рассмотрим такой случай:
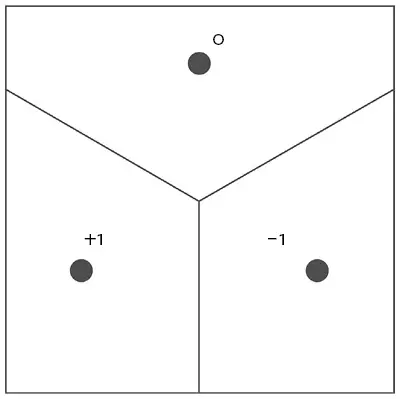
Наша цель состоит в том, чтобы получить входные данные, соответствующие позиции {x, y}, а затем «распознать» их, то есть отнести к той из трех точек, к которой они находятся ближе всего. Или, другими словами, мы хотим, чтобы нейронная сеть вычисляла функцию от {x, y} следующим образом:
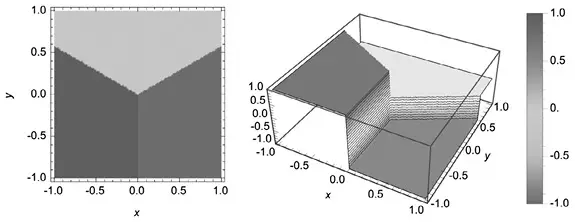
Как же мы можем это сделать? В конечном счете нейронная сеть представляет собой связанную совокупность нейронов, обычно расположенных слоями. Простой пример выглядит так:
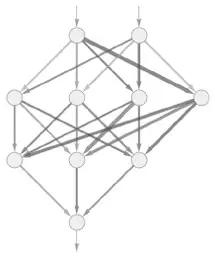
Каждый «нейрон» производит вычисление простой числовой функции. Чтобы задействовать всю сеть, мы просто вводим числа (например, наши координаты x и y) на самом верхнем слое, затем заставляем нейроны каждого следующего слоя вычислять простую числовую функцию и передавать результаты вычисления дальше по сети и в итоге в самом низу получаем:
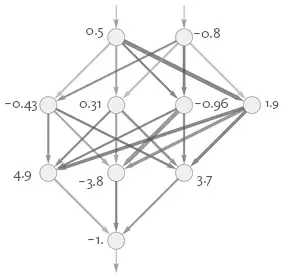
В традиционной (вдохновленной биологией) установке каждый нейрон фактически имеет определенный набор входящих соединений от нейронов предыдущего уровня, причем каждому соединению присваивается вес, который может быть выражен положительным или отрицательным числом. Значение конкретного нейрона определяется путем умножения значений предыдущих нейронов на их веса, затем сложения результатов, далее добавления константы и, наконец, применения функции порогового значения (или активации). В математических терминах: если у нейрона есть входные данные x = {x1, x2 …}, то мы вычисляем f[wx + b], где обычно вес w и константа b выбираются по-разному для каждого нейрона в сети, а функция f не меняется.
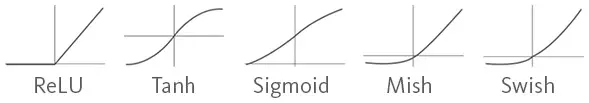
Вычисление wx + b – это всего лишь вопрос умножения и сложения матриц. Функция активации f вводит нелинейность, и в конечном счете именно это приводит к нетривиальному поведению. Обычно используются различные функции активации (на иллюстрации ниже – их примеры). Здесь мы просто применим Ramp (или ReLU):
Для каждой задачи, которую нейронная сеть должна выполнить (или, что эквивалентно, для каждой общей функции, которую мы хотим вычислить), у нас будут разные варианты весов. И, как мы обсудим позже, эти веса обычно определяются путем «обучения» нейронной сети на примерах нужных нам выходных данных.
В конечном счете каждая нейронная сеть просто соответствует некоей общей математической функции (хотя ее может быть сложно записать). Для приведенного выше примера это была бы следующая запись:
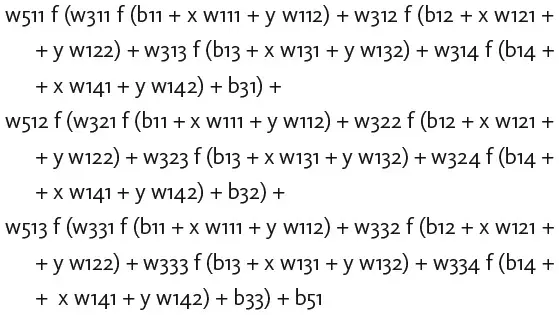
Нейронная сеть ChatGPT так же просто реализует математическую функцию, подобную этой, но с миллиардами данных.
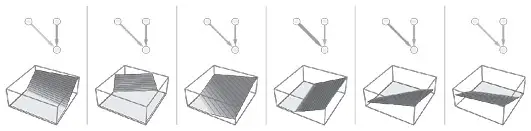
Однако давайте вернемся к отдельным нейронам. Вот несколько примеров функций, которые нейрон с двумя входными данными (представляющими координаты x и y) может вычислять при различных вариантах весов и констант (и Ramp в качестве функции активации):
Но как насчет более крупной сети сверху? Вот что у нас получается:
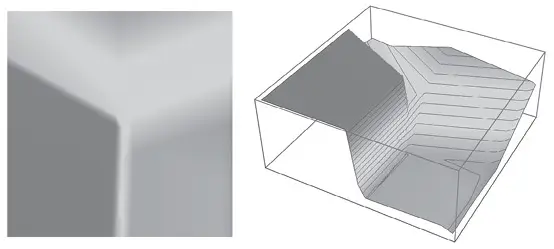
Это не совсем правильно, но близко к функции ближайшей точки, которую мы описали выше.
Давайте посмотрим, что происходит с некоторыми другими нейронными сетями. Как вы